四、F分布与方差分析
前面我们已经认识了正态分布、卡方分布和 t 分布。它们之间存在一条很清晰的知识链:正态分布帮助我们研究样本均值,卡方分布帮助我们研究样本方差,t 分布则将两者结合起来,解决总体标准差未知时的均值推断问题。
接下来,我们要认识 F 分布(F-distribution)。它同样与正态分布和卡方分布密切相关,但它要解决的问题有所不同:当我们需要比较两个总体的方差,或者判断多个群体的平均值是否存在差异时,应该怎么办?
这一章分为两个相互关联的部分。首先介绍 F 分布的数学来源、自由度和概率密度曲线;然后介绍方差分析(Analysis of Variance,简称 ANOVA),看看统计学家是怎样利用 F 分布,一次性比较多个群体的平均值的。
F分布的由来
我们先从一个简单的问题开始。假设我们分别从两个正态总体中抽取样本,计算得到它们的样本方差 和 。现在,我们想知道这两个总体的波动程度是否相同,也就是判断它们的总体方差 和 是否相等。
前面我们已经知道,样本方差本身是一个随机变量。对于来自正态总体的独立随机样本,有这样一个重要结论:
也就是说,经过适当标准化之后,两个样本方差分别可以转化为服从卡方分布的随机变量。由于两个样本来自相互独立的总体,因此这两个卡方随机变量也相互独立。
现在,我们把它们分别除以各自的自由度,再相除,就得到了一个新的统计量:
化简后:
这个统计量服从 F 分布。特别地,如果我们假设两个总体的方差相等,即 ,那么上面的公式就可以进一步简化为:
这就是 F 分布最初的重要应用之一:比较两个正态总体的方差是否相等。它的名字来自英国统计学家罗纳德·费希尔(Ronald Fisher)。费希尔在20世纪20年代发展了相关理论,并将这种分布应用于农业实验和统计推断。
不过,F 分布的用途并不止于比较两个方差。后来统计学家发现,只要能够构造出两个相互独立的卡方随机变量,并分别除以各自的自由度,再将两者相除,就可以得到 F 分布。这使它成为一种非常通用的统计工具,也为后面要介绍的方差分析奠定了数学基础。
F分布的基本形式
假设 和 是两个相互独立的卡方随机变量,分别具有 和 个自由度:
那么,我们定义一个新的随机变量:
它就服从自由度分别为 和 的 F 分布,记作:
这里需要特别注意,F 分布有两个自由度: 是分子自由度, 是分母自由度。两者的顺序不能颠倒。它们分别来自分子和分母中的两个卡方随机变量。
F 分布的概率密度函数为:
其中 , 仍然是我们在卡方分布中遇到过的伽马函数。这个公式看起来相当复杂,但实际上我们不需要从头推导它。只需要记住 F 分布是两个经过自由度标准化的卡方随机变量之比,就足以理解它的基本原理。
与正态分布和 t 分布不同,F 分布只能取正值,而且通常呈现明显的右偏形状。原因也很直观:它是两个非负随机变量的比值,结果不可能小于零;当分母偶然取得很小的值时,整个比值就可能变得非常大,因此曲线右侧会拖着一条长尾。
F 分布还有一个非常重要的特点:它的形状由两个自由度共同决定。分子自由度和分母自由度分别影响分子、分母的波动程度,因此即使其中一个自由度相同,只要另一个自由度发生变化,最终的分布也可能明显不同。
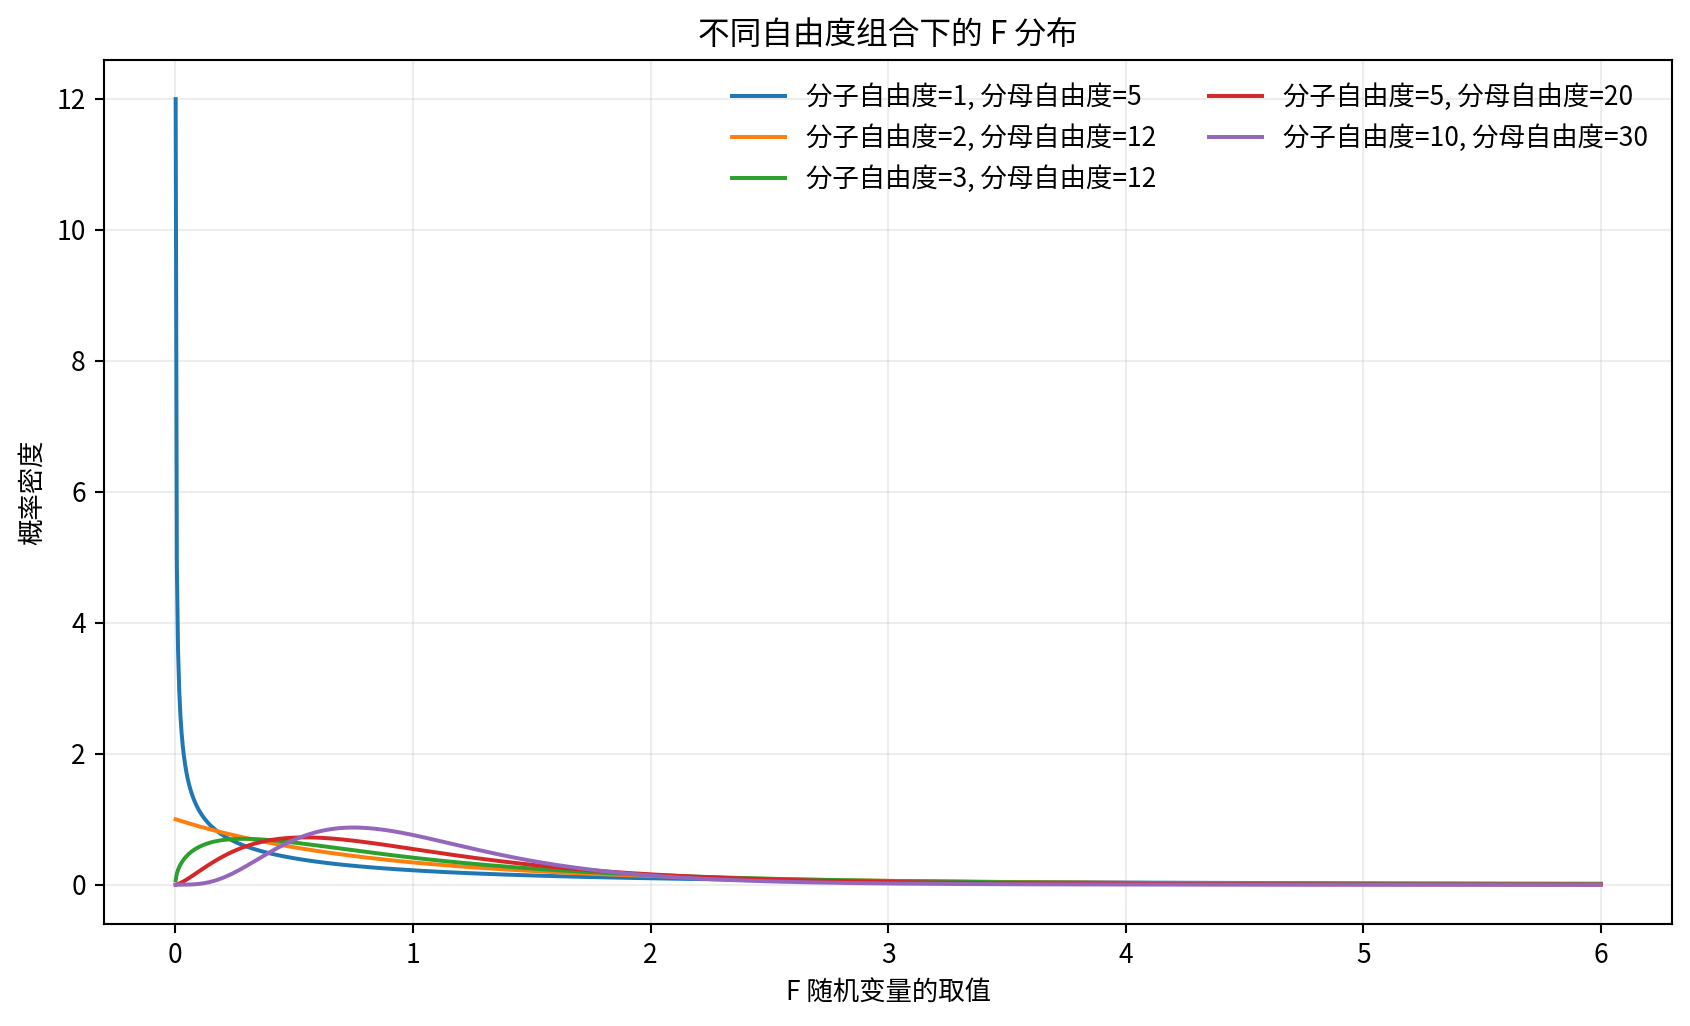
从图中可以看到,当自由度较小时,F 分布通常具有较长的右尾;随着两个自由度逐渐增加,分布会越来越集中。特别是当分子和分母的自由度都比较大时,F 分布的取值会越来越集中在1附近。这是因为两个经过自由度标准化的卡方随机变量,其数学期望都等于1,而且随着自由度增加,它们的随机波动会逐渐减小,因此两者的比值也就越来越接近1。
F 分布还有一个值得注意的数学性质。如果 服从自由度为 的 t 分布,那么:
这意味着,t 分布实际上可以看作 F 分布的一种特殊情况:当 F 分布的分子自由度为1时,它与相应自由度的 t 分布平方之间存在直接关系。前面我们学习的单样本 t 检验,如果把 t 统计量平方,就可以转化为一个分子自由度为1的 F 统计量。两种方法最终会得到相同的双侧检验结论。
至此,我们已经认识了 F 分布的基本形式。它的核心思想其实并不复杂:将两个独立的方差估计进行比较,看看它们的比值究竟有多大。接下来,我们就要把这个思想进一步推广,看看它能否帮助我们同时比较三个、四个甚至更多群体的平均值。
从t检验到方差分析
假设我们想知道三种不同饲养方案是否会影响鸟类的平均体重。现在,我们分别采用三种饲养方案,每种方案随机选取5只鸟,经过一段时间后测量它们的体重,得到以下数据,单位为克:
| 饲养方案 A | 饲养方案 B | 饲养方案 C |
|---|---|---|
| 28 | 30 | 33 |
| 30 | 32 | 35 |
| 29 | 31 | 36 |
| 31 | 33 | 34 |
| 32 | 34 | 37 |
| 平均值:30 | 平均值:32 | 平均值:35 |
从数据来看,三种饲养方案下鸟类的平均体重分别为30克、32克和35克。乍一看,方案C似乎比方案A更有利于鸟类增重。但这只是样本结果,我们仍然需要判断这些差异是否足够明显,能否排除正常随机波动的解释。
如果只有两个群体,我们可以使用前面学过的独立样本 t 检验。但现在有三个群体,难道要分别比较A和B、A和C、B和C吗?理论上当然可以这样做,但如果群体数量继续增加,比较次数也会迅速增加。假设我们有5个群体,就需要进行10次两两比较;如果有10个群体,就需要进行45次比较。检验次数越多,至少出现一次假阳性结果的风险通常也会越高。
因此,我们需要一种能够一次性比较多个群体平均值的方法。这就是方差分析(ANOVA)。
它的名字可能有些令人困惑。既然我们想比较的是不同群体的平均值,为什么不叫平均值分析,而叫方差分析?原因在于,ANOVA 并不是直接拿几个平均值进行比较,而是通过分析数据整体的变异,将不同群体之间的差异与群体内部的随机波动进行比较,最终判断各群体的平均值是否存在显著差异。
方差分析的基本思想
我们先观察刚才的三个饲养方案。A组的平均体重为30克,B组为32克,C组为35克。三组的总体平均值,也就是把15只鸟的体重全部加起来再除以15,得到:
由于每组样本数量相同,也可以直接计算三个组均值的平均数:
这个数值称为总平均值(Grand Mean)。现在,我们可以把每只鸟的体重与总平均值之间的差异,分解成两个部分:第一部分是它所在组的平均值与总平均值之间的差异;第二部分是它自己的体重与所在组平均值之间的差异。
例如,A组中有一只体重为28克的鸟。它与总平均值32.333克之间相差:
这个差异可以拆分为:
前一部分表示A组平均体重与总体平均体重之间的差异,后一部分表示这只鸟与A组平均体重之间的差异。
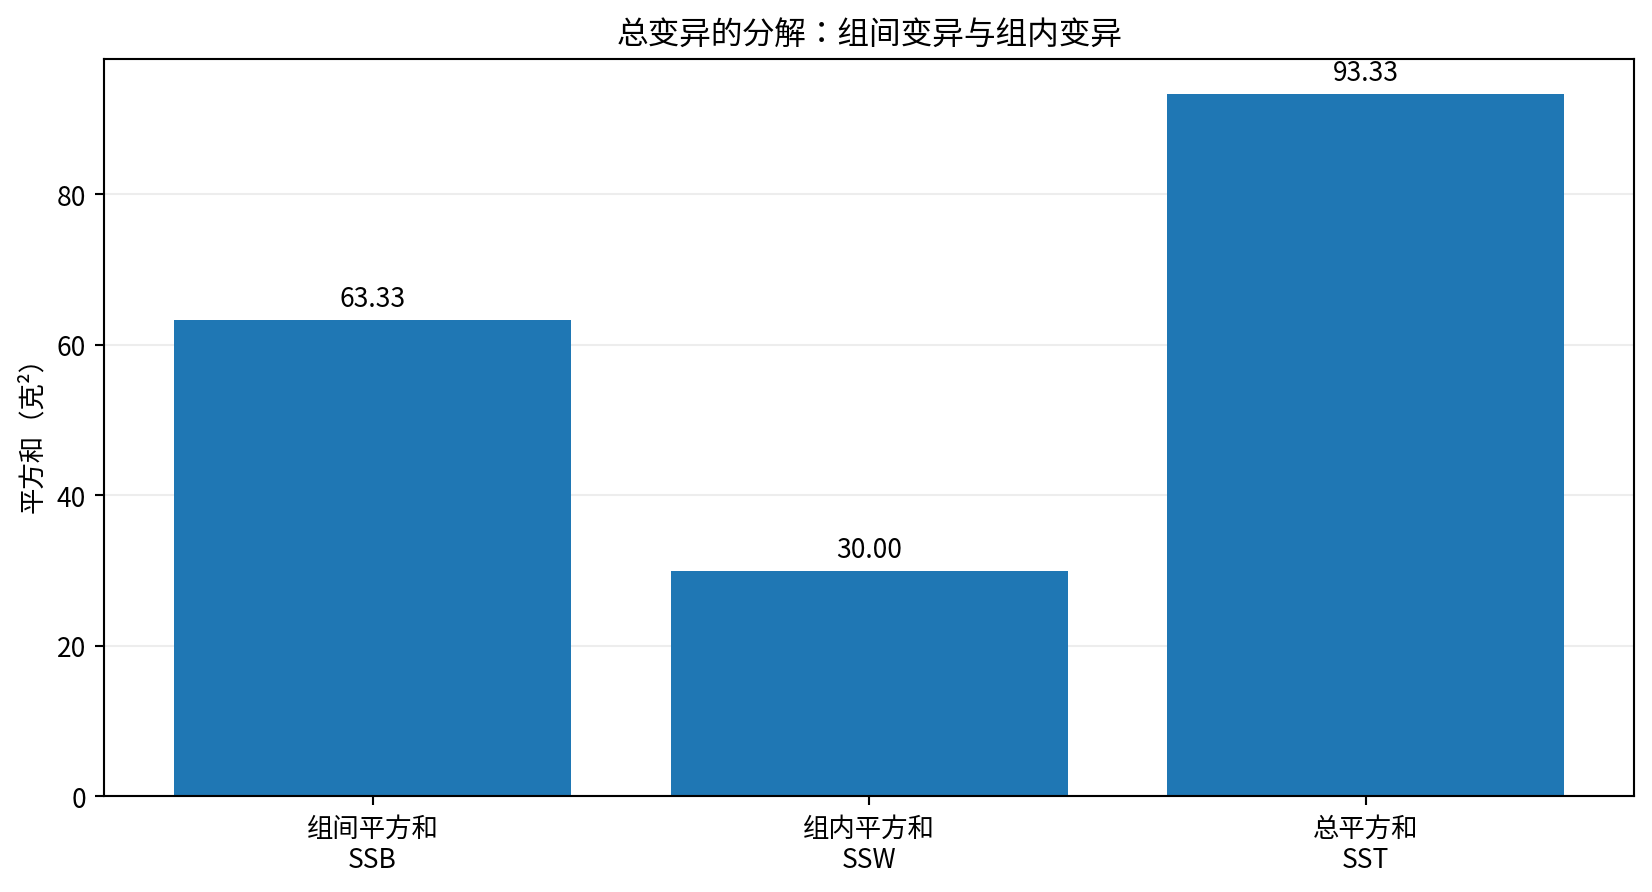
这就引出了方差分析最重要的思想:全部数据的变异,可以分解为组间变异和组内变异。
组间变异(Between-group Variation),指的是不同组的平均值之间存在多大的差异。如果三个饲养方案下的鸟类平均体重相差很大,那么组间变异就会比较大。组内变异(Within-group Variation),则指的是同一个组内部,各个观测值围绕本组平均值的波动程度。如果同一饲养方案下的鸟类体重非常接近,那么组内变异就会比较小。
我们可以把这两种变异理解为两个不同的来源:组间变异反映了不同饲养方案之间的差异,而组内变异反映了即使饲养方案相同,个体之间仍然存在的自然差异。
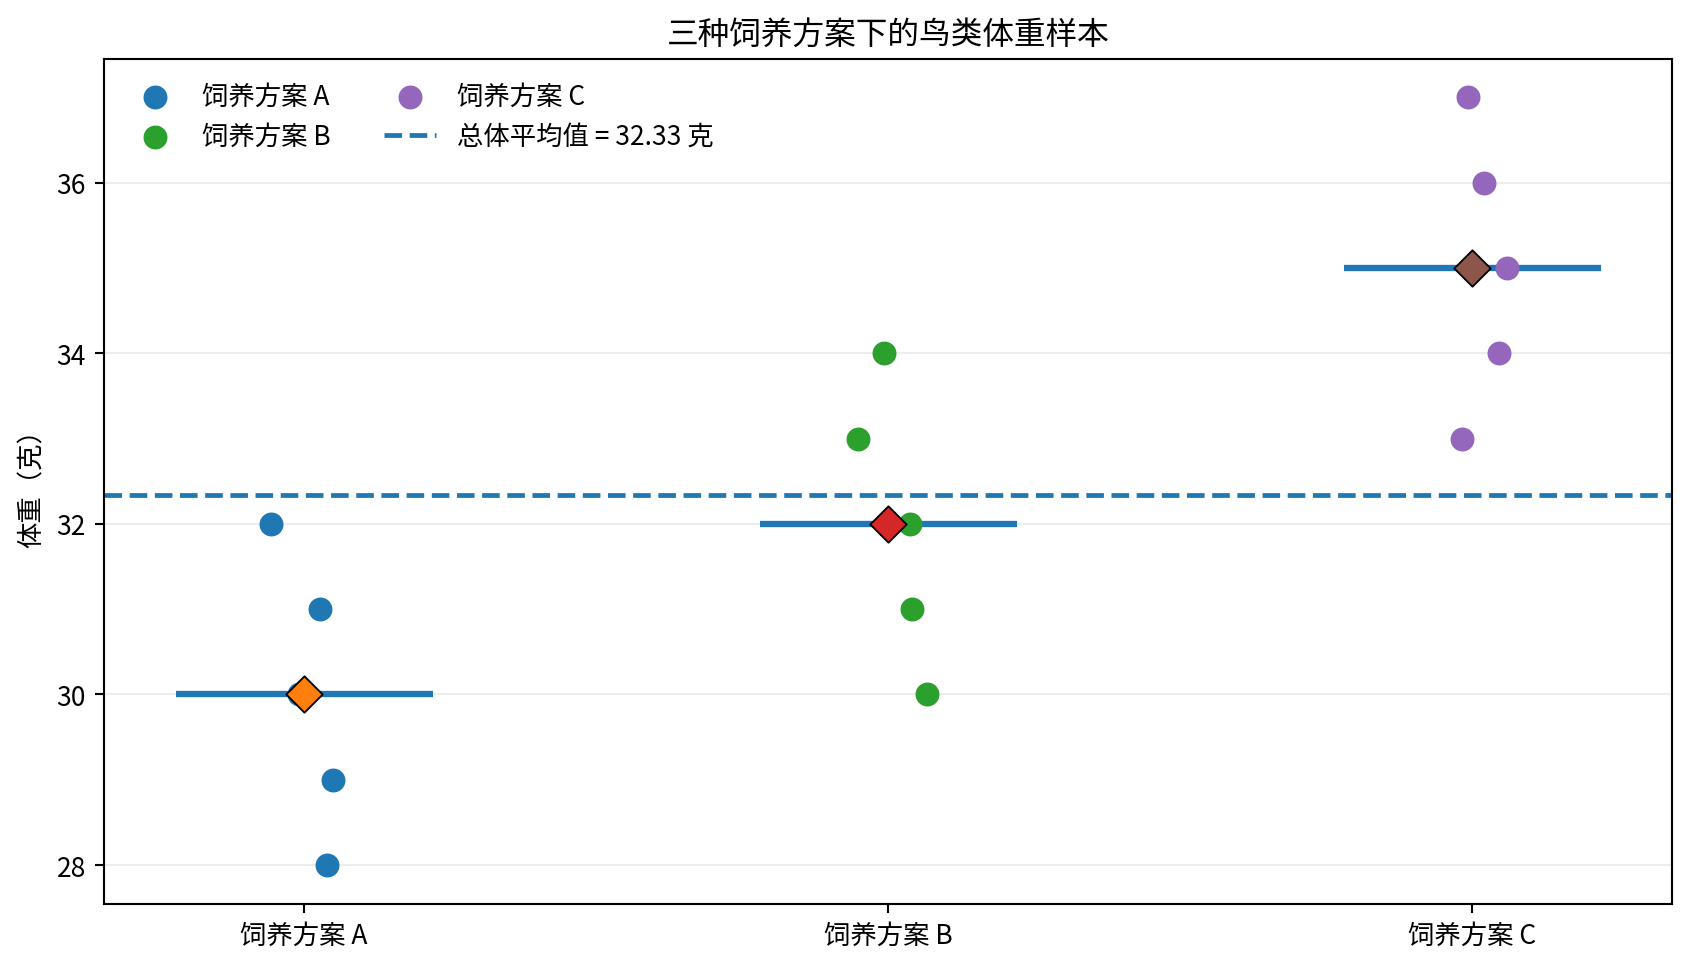
现在,假设三种饲养方案实际上完全没有区别,那么A、B、C三组的总体平均体重就应该相等。此时,我们观察到的组间差异主要来自随机抽样,因此组间变异不应该远远大于组内变异。反过来,如果不同饲养方案确实会影响鸟类体重,那么不同组的平均值就可能出现明显差异,组间变异也就会相对于组内变异增大。
因此,我们只需要比较这两种变异的大小,就能够判断不同组的平均值是否存在显著差异。
总变异的分解
为了更加准确地衡量组间变异和组内变异,我们需要引入平方和(Sum of Squares,简称 SS)。
首先是总平方和(Total Sum of Squares,SST),它表示所有观测值与总平均值之间的差异平方之和:
其中, 表示组数, 表示第 组的样本数量, 表示第 组第 个样本的观测值, 表示所有样本的总平均值。
其次是组间平方和(Between-group Sum of Squares,SSB),它衡量不同组的平均值与总平均值之间的差异:
这里的 表示第 组的平均值。之所以要乘以 ,是因为每组平均值与总平均值之间的偏差,实际上代表了这一组所有样本的组间偏差。样本数量越多,这种组间差异对整体变异的贡献也就越大。
最后是组内平方和(Within-group Sum of Squares,SSW),它衡量每个组内部的观测值与本组平均值之间的差异:
这三个平方和之间存在一个非常重要的关系:
也就是说,所有观测值与总平均值之间的总变异,恰好可以分解成组间变异和组内变异。
我们把刚才的鸟类体重数据代入计算,可以得到:
两者相加:
完全符合总变异的分解关系。
F统计量的构造
现在,我们已经知道如何分别计算组间变异和组内变异。但问题仍然存在:63.333和30这两个数字究竟算大还是算小?我们需要一个能够进行比较的标准。
这时候就要引入均方(Mean Square,简称 MS)。所谓均方,就是将平方和除以对应的自由度。为什么要这样做?因为组间平方和与组内平方和所包含的独立信息数量并不相同,不能直接拿两个平方和相除。通过除以自由度,我们可以把它们转换成具有可比性的变异估计。
首先,组间自由度为:
在我们的例子中,一共有3组,因此:
组内自由度为:
其中 表示全部样本的数量。我们一共调查了15只鸟,因此:
总自由度则为:
这里同样可以发现,自由度具有可加性:
接下来,我们分别计算组间均方和组内均方:
最后,将两者相除,就得到了 F 统计量:
代入数据:
为什么要使用这个比值?关键在于,在原假设成立时,三个群体的总体平均值实际上相等。此时,组间均方和组内均方都可以用来估计同一个总体方差,因此两者的比值通常不会太大,应该在1附近波动。如果不同群体的总体平均值确实存在差异,那么组间均方就会受到这种差异的影响而增大,而组内均方仍然主要反映各组内部的随机波动。最终,F 统计量就会变大。
因此,我们可以这样理解:F 统计量衡量的是组间变异相对于组内变异究竟有多大。 F 值越大,说明不同组的平均值之间的差异,相对于组内的随机波动越明显。
方差分析与F分布
现在我们终于可以把前面学过的 F 分布和方差分析联系起来了。
在单因素方差分析中,假设我们有 个独立群体,总样本量为 。在原假设成立,并且满足正态性、方差齐性和独立性等条件时,有:
而且,这两个经过标准化的平方和相互独立。因此,我们将它们分别除以各自的自由度,再相除,就可以得到:
这就是方差分析为什么使用 F 分布的原因。它实际上是将组间平方和与组内平方和分别转化为卡方分布,再通过相除得到 F 分布。
在我们的鸟类调查中,组间自由度为2,组内自由度为12,因此在原假设成立时,F 统计量服从自由度为2和12的 F 分布:
而我们实际计算得到的 F 统计量为12.667。接下来,就可以利用 F 分布计算 P-value,判断这个数值究竟有多异常。
方差分析的检验过程
与前面学习的卡方检验和 t 检验一样,方差分析也需要先提出原假设和备择假设。
在我们的例子中,原假设是三种饲养方案下鸟类的总体平均体重完全相等:
备择假设则是:
这里需要特别注意,备择假设并不是说三个总体平均值全部不同,而只是说它们不可能全部相等。只要有至少两个总体平均值存在差异,就可以拒绝原假设。
前面我们已经计算得到:
对应的分子自由度为2,分母自由度为12。由于 F 分布主要关注较大的比值,因此我们需要计算观测到当前 F 值或更大 F 值的右尾概率。
计算得到:
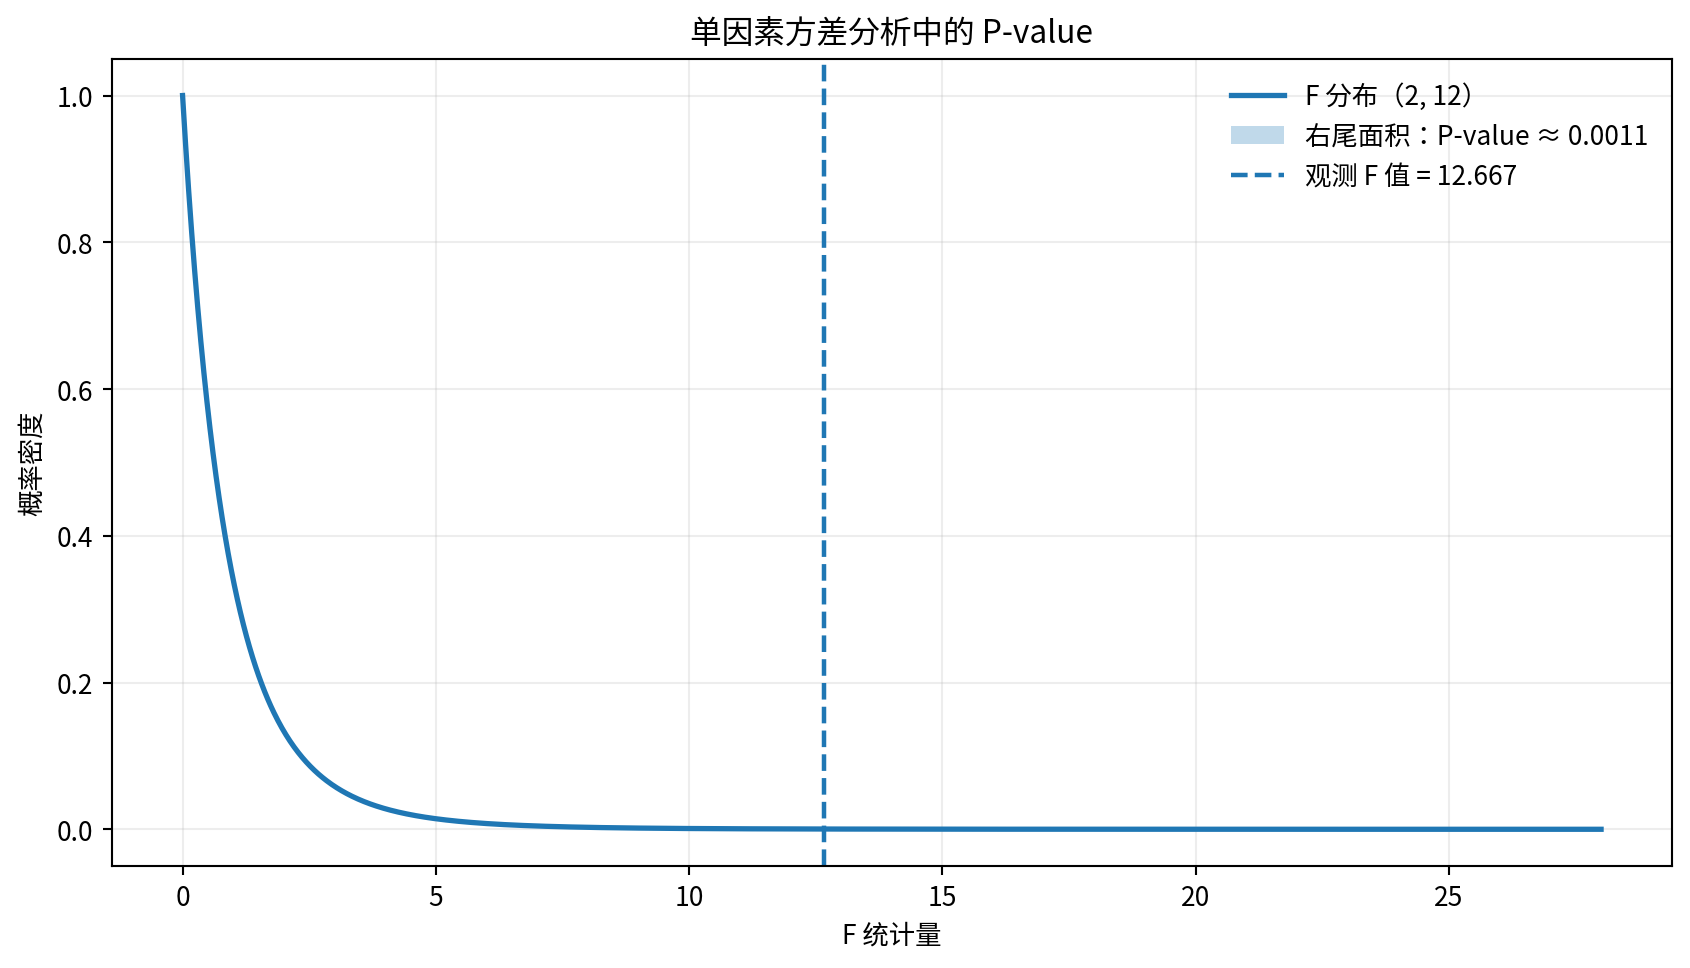
假设我们事先设定显著性水平为5%,即 。由于:
因此,我们拒绝原假设,认为三种饲养方案下鸟类的总体平均体重并不完全相同,至少有一组与其他组存在统计显著的差异。
这也意味着,F 分布帮助我们完成了一件非常重要的事情:我们不必分别对A、B、C三个组进行多次 t 检验,只需要通过一次方差分析,就可以判断这些群体的总体平均值是否全部相等。
方差分析的类型与进一步检验
刚才介绍的是单因素方差分析(One-way ANOVA)。它只研究一个因素对某个连续变量的影响。例如,我们只研究饲养方案这一因素,看看不同饲养方案是否会影响鸟类体重。这里的「因素」就是我们主动区分的研究条件,而因素的不同取值称为水平。饲养方案A、B、C就是三个水平。
如果我们同时研究两个因素,例如既研究饲养方案,又研究鸟类的年龄,那么就可以使用双因素方差分析(Two-way ANOVA)。它不仅能够研究饲养方案本身的影响,还可以研究年龄本身的影响,以及两个因素之间是否存在交互作用。例如,某种饲养方案可能对成年鸟类效果明显,却对幼鸟效果不明显,这就可能存在交互作用。
此外,如果我们对同一批对象进行多次测量,例如分别记录同一批鸟在喂养前、喂养一个月后和喂养三个月后的体重,那么就涉及重复测量方差分析(Repeated Measures ANOVA)。它需要考虑同一对象多次测量之间的相关性,不能直接把所有观测值当作相互独立的样本。
不过,无论采用哪一种方差分析,其基本思想都是相似的:将总体变异分解为不同来源,计算相应的均方,再通过 F 统计量判断不同因素是否对研究结果产生了显著影响。
这里还存在一个重要问题。假设我们通过方差分析发现,三种饲养方案的总体平均体重并不完全相同,那么究竟是A和B不同,还是A和C不同,抑或B和C不同?单纯的 F 检验并不能直接回答这个问题。它只能告诉我们至少有一组平均值存在差异,却不能指出具体是哪几组。
因此,在方差分析之后,我们通常还需要进行事后多重比较(Post-hoc Tests)。例如,可以使用 Tukey HSD 检验,对不同组之间的平均值进行两两比较,并且控制多重比较带来的第一类错误风险。这样,我们就可以进一步判断究竟哪些饲养方案之间存在显著差异。
方差分析的适用条件与局限性
方差分析虽然非常有用,但它同样存在一定的适用条件。首先,各组样本应当具有合理的随机性,不同观测值之间需要相互独立。其次,各组数据或模型残差通常需要近似服从正态分布。最后,传统单因素方差分析还要求各组总体方差大致相等,这被称为方差齐性(Homogeneity of Variance)。
如果不同组的方差差异很大,尤其是各组样本量又不相等时,传统方差分析可能会产生不可靠的检验结果。这种情况下,可以考虑使用 Welch 方差分析,它不要求各组具有完全相同的方差。若数据存在严重偏态、极端值或者其他不适合参数检验的情况,也可以根据研究问题考虑 Kruskal-Wallis 检验等非参数方法。
此外,方差分析与 t 检验一样,主要回答的是差异是否具有统计显著性,而不是差异究竟有多大的现实意义。样本量足够大时,即使不同组之间的平均值只相差很小,也可能得到显著的 P-value。因此,实际研究中还应该结合效应量、置信区间和具体研究背景进行判断。
更重要的是,方差分析本身并不能证明某个因素与结果之间存在因果关系。如果我们只是观察不同地区鸟类的平均体重,发现它们存在显著差异,并不能直接认定地区环境就是造成差异的原因。只有结合合理的实验设计、随机分组以及对其他影响因素的控制,才能进一步讨论因果关系。