承接上文……
三、t分布:当总体标准差未知时
在上一章中,我们认识了卡方分布,并知道它可以由若干个相互独立的标准正态随机变量的平方和构成。卡方分布让我们能够衡量分类数据与理论预期之间的偏差,但它还有一个重要用途:帮助我们研究样本方差的分布。接下来,我们就要利用这个性质解决另一个统计学问题。
假设我们想知道某地区某种鸟类的平均体重。我们随机抽取一部分鸟类,测量它们的体重,然后计算样本平均值。现在的问题是:这个样本平均值究竟能不能代表整个地区鸟类的平均体重?如果我们知道所有鸟类体重的总体标准差,那么可以直接利用正态分布进行标准化,计算样本平均值与总体平均值之间的差异。但现实中,我们通常不知道总体标准差,只能根据抽取到的样本计算样本标准差。问题也就随之产生:当我们用样本标准差代替总体标准差时,原来的正态分布还能不能继续使用?这正是 t 分布要解决的问题。
从鸟类体重调查说起
假设我们现在调查某地区一种鸟类的平均体重。为了便于说明,我们随机抽取了10只鸟,测量得到以下数据,单位为克:
| 编号 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 体重 | 28 | 31 | 30 | 29 | 32 | 27 | 33 | 30 | 29 | 31 |
首先计算这10只鸟的平均体重:
因此,我们得到的样本平均体重为30克。假设过去的调查资料表明,这种鸟类的平均体重应该是29克,我们现在想知道:本次调查得到的30克,是否足以说明当地鸟类的平均体重已经发生了变化?
这里我们遇到了一个熟悉的问题:样本平均值与理论平均值之间存在差异,但这种差异究竟来自正常的随机波动,还是来自总体本身的变化?
如果我们知道总体标准差,就可以利用正态分布计算这种差异出现的概率。但问题恰恰在于,我们不知道总体标准差。我们只有这10只鸟的体重数据,只能通过它们计算样本标准差。
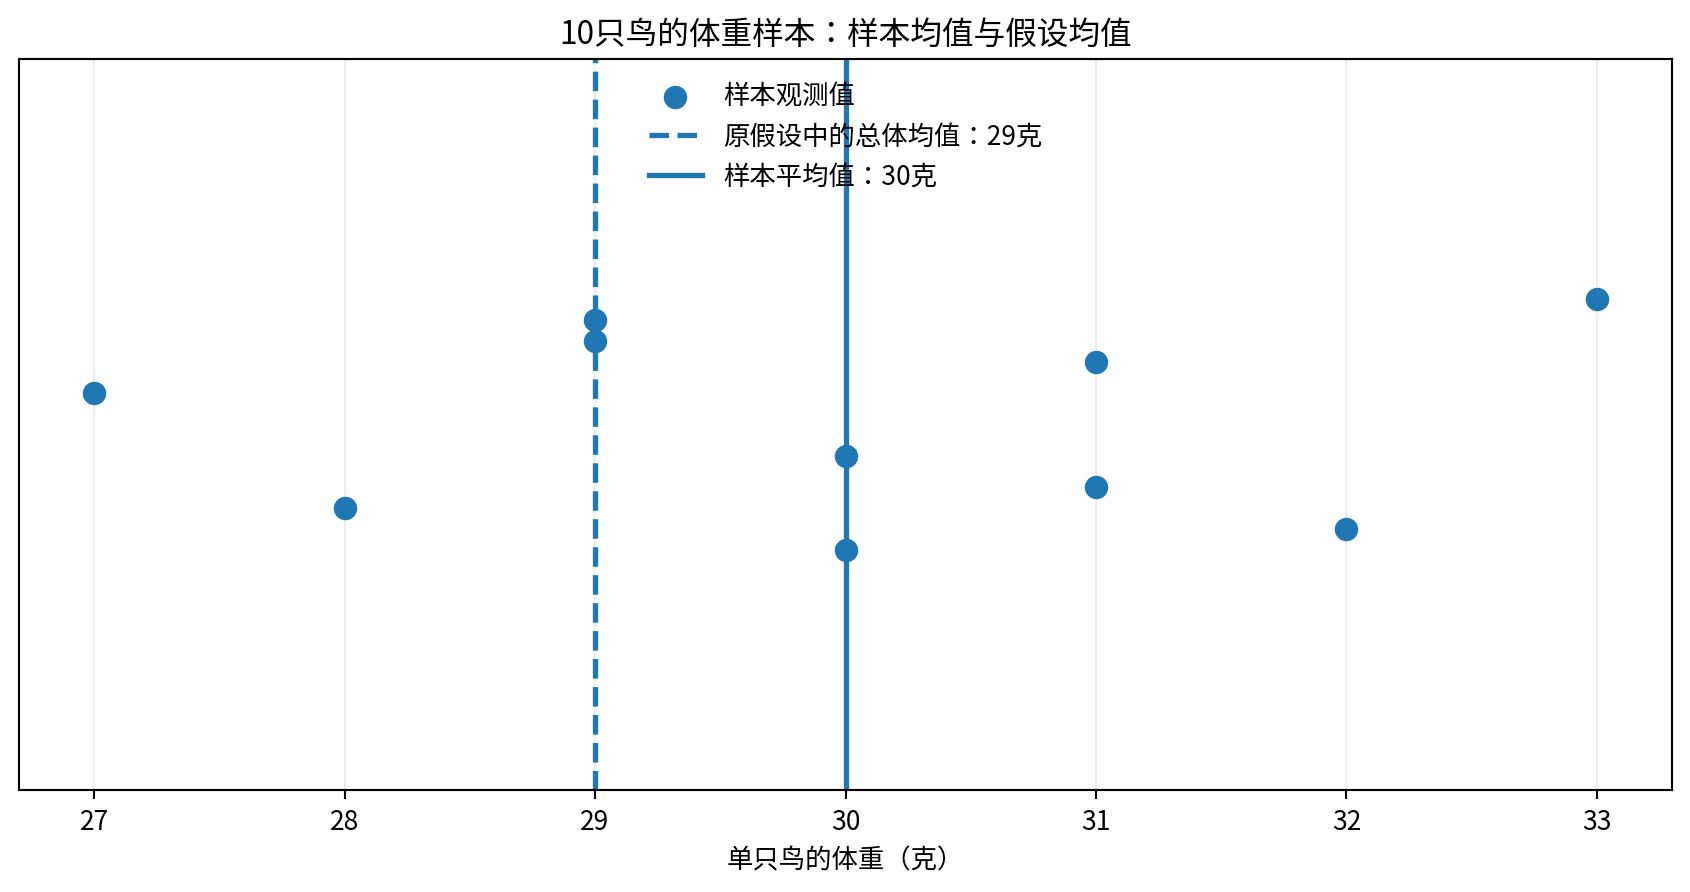
这时候,我们就需要思考一个问题:既然总体标准差无法直接获得,能不能用样本标准差代替它?如果可以,那么代替之后又会对原来的统计方法产生什么影响?
从正态分布到t分布
我们先回忆一下正态分布中的标准化公式。假设总体服从正态分布,数学期望为 ,标准差为 ,那么从这个总体中随机抽取 个样本,其样本平均值也服从正态分布:
因此,我们可以将样本平均值标准化:
这里的 就是样本平均值的标准差,也称为标准误(Standard Error)。它描述的是:如果我们不断重复抽样,每次都计算一个样本平均值,那么这些样本平均值之间通常会有多大的波动。它与单个观测值的标准差并不是一回事。总体标准差 描述的是个体数据的离散程度,而标准误描述的是样本平均值的抽样波动程度。
不过,上面的公式有一个前提:我们必须知道总体标准差 。现实中,这个数值通常无法直接获得。我们能做的,就是根据样本数据计算样本标准差 ,然后用它来估计总体标准差。
样本标准差的计算公式为:
于是,我们自然想到将原来公式中的 替换为 :
但是,这个替换并不像看起来那么简单。原来的总体标准差 是一个固定但未知的参数,而样本标准差 则是根据随机抽样得到的数据计算出来的随机变量。每次重新抽样,样本标准差都可能发生变化。因此,我们在计算标准化统计量时,不仅样本平均值在变化,分母也在变化。
这意味着,原来那个标准正态分布已经不能直接描述这个新统计量的精确取值规律了。尤其是在样本量较小时,样本标准差本身存在较大的不确定性,这种不确定性会进一步影响最终的统计判断。我们需要一种新的概率分布,将这种额外的不确定性考虑进去。
这就是 t 分布产生的原因。它并不是要取代正态分布,而是在总体标准差未知、需要通过样本标准差进行估计时,为我们提供一种更加合适的统计工具。
t分布的由来
t 分布也叫 Student’s t-distribution,中文通常称为学生 t 分布。它的产生有一个比较有意思的历史故事。
20世纪初,英国统计学家威廉·西利·戈塞特(William Sealy Gosset)在爱尔兰的吉尼斯啤酒厂工作。当时,啤酒生产需要进行大量实验,例如研究不同原料、酿造条件和生产工艺对最终产品的影响。但这些实验往往成本较高,能够获得的样本数量非常有限。传统的大样本统计方法在这种情况下并不总是可靠,尤其是当总体标准差未知时,仅仅用样本标准差代替总体标准差,可能会造成明显的统计误差。
为了解决这个问题,戈塞特开始研究小样本条件下的统计推断,并于1908年在《Biometrika》期刊上发表了著名论文《The Probable Error of a Mean》。由于吉尼斯啤酒厂对员工发表研究成果有保密要求,他使用了笔名 Student 发表论文。后来,这套分布便以 Student 命名,成为我们今天所说的 Student’s t-distribution。
戈塞特的研究最初来自酿酒实验中的实际困难,但它的意义远远超出了啤酒生产。它使人们能够在样本数量有限、总体标准差未知的情况下,对总体平均值进行更加可靠的统计推断。此后,统计学家费希尔(Ronald Fisher)进一步发展了相关理论,使 t 分布成为现代统计学中最常用的概率分布之一。
t分布的数学定义
现在我们已经知道,t 分布是为了解决总体标准差未知的问题而产生的。但它究竟是怎样从正态分布和卡方分布中构造出来的?
在上一章中,我们已经知道,若干个相互独立的标准正态随机变量平方后求和,就会得到一个服从卡方分布的随机变量。而在这里,我们可以利用卡方分布来描述样本方差的随机变化。
假设我们从一个正态总体中随机抽取 个样本,得到样本平均值 和样本标准差 。根据数理统计中的一个重要结论,有:
同时,样本方差与卡方分布之间存在以下关系:
这里的 和 相互独立。这一点非常重要,因为它允许我们将两个随机变量组合起来,构造出一个新的概率分布。
根据卡方分布的性质,我们可以进一步构造:
将前面两个随机变量的定义代入:
经过化简:
最终,我们得到:
这就是 t 分布最重要的数学定义:一个标准正态随机变量,除以一个经过自由度调整的卡方随机变量平方根,并且两者相互独立,最终得到的随机变量服从 t 分布。
这里的自由度为 ,其中 是样本数量。需要注意,这个结论在总体服从正态分布、样本独立同分布的条件下是精确成立的。如果总体并不服从正态分布,那么小样本情况下不能直接保证这个结论成立;不过在满足适当条件的大样本情况下,t 统计量通常也可以获得良好的近似。
至此,我们就把正态分布、卡方分布和 t 分布联系了起来:正态分布提供了样本平均值的标准化基础,卡方分布描述了样本方差的随机变化,而 t 分布则将这两部分结合起来,解决了总体标准差未知时的均值推断问题。
自由度与分布形状
我们已经知道,t 分布的自由度通常为 。那么,这个自由度究竟意味着什么?
其实,我们在上一章已经接触过类似的问题。假设我们有 个样本,它们的平均值已经确定,那么每个样本与平均值之间的偏差之和必然等于零:
这意味着,如果我们已经知道前面 个样本的偏差,那么最后一个样本的偏差就可以通过总和为零的条件确定。换句话说,虽然我们计算了 个偏差,但真正能够独立变化的只有 个。
这就是为什么样本方差的计算需要除以 ,也解释了为什么 t 分布的自由度通常为 。这里的自由度并不是一个单纯为了计算而出现的参数,它反映了我们在估计样本波动程度时,实际上拥有多少个独立变化的信息。
与正态分布一样,t 分布也是一条左右对称的钟形曲线,其中心位于0。但两者有一个非常重要的区别:t 分布的尾部比标准正态分布更厚。
为什么会这样?因为我们在构造 t 统计量时,使用的不是一个固定的总体标准差,而是一个随机变化的样本标准差。样本标准差有时可能偏大,有时也可能偏小。当它偶然偏小时,分母就会变小,最终计算出来的 t 值就可能变得很大。因此,与标准正态分布相比,t 分布出现较大正值或较大负值的概率更高。
我们可以把不同自由度下的 t 分布与标准正态分布放在一起比较:
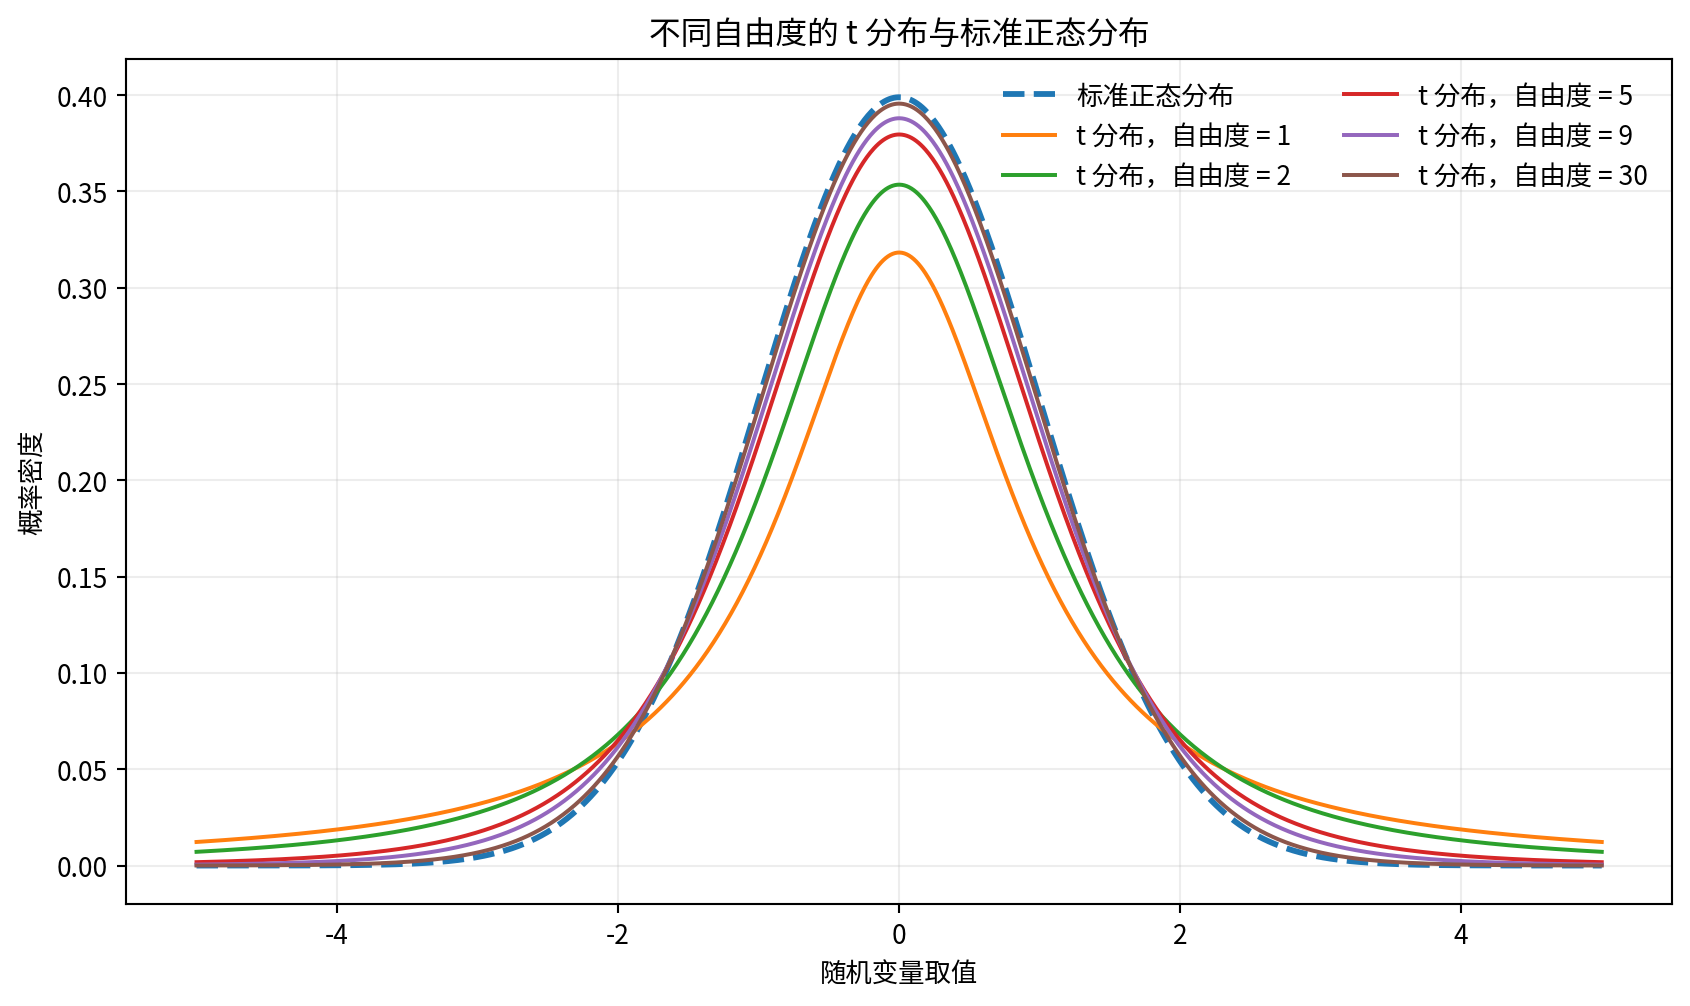
可以看到,自由度为1时,t 分布的尾部非常厚,曲线中心也比较低;随着自由度增加,曲线逐渐变得集中,尾部越来越薄,最终接近标准正态分布。这是因为样本量越大,样本标准差通常越能够稳定地估计总体标准差,分母中的随机不确定性也就逐渐减小。
t 分布还有几个重要的数学性质。首先,它关于0对称,因此在自由度大于1时,数学期望为0:
其次,它的方差为:
其中, 表示自由度。可以看到,t 分布的方差大于1,而标准正态分布的方差恰好等于1。这也反映了 t 分布具有更大的离散程度。需要注意,自由度为1时,t 分布没有有限的数学期望和方差;自由度为2时,方差也不存在。
随着自由度不断增加,t 分布最终会趋近于标准正态分布:
这也解释了为什么在大样本条件下,t 分布和标准正态分布的计算结果会越来越接近。不过,这并不意味着 t 分布只适用于样本量小于30的情况。只要总体标准差未知,我们就可以使用 t 分布进行均值推断;即使样本量很大,使用 t 分布也是完全合理的,只不过此时它与标准正态分布的差异已经非常小。
t检验
现在,我们终于可以回到最初的鸟类调查,看看 t 分布究竟怎样解决实际问题。
我们已经知道,10只鸟的样本平均体重为30克,样本标准差为:
那么,样本平均值的标准误就是:
这里需要再次区分标准差和标准误。标准差描述的是单只鸟的体重在样本中的离散程度,而标准误描述的是样本平均体重的抽样波动程度。样本数量越多,样本平均值通常越稳定,因此标准误会随着样本量增加而减小。
假设我们要检验当地这种鸟类的总体平均体重是否仍然为29克,那么可以提出以下两个假设:
其中, 是原假设,表示总体平均体重仍然为29克; 是备择假设,表示总体平均体重已经不等于29克。
根据前面介绍的 t 统计量公式,我们可以计算:
代入数据:
由于样本数量为10,因此自由度为:
接下来,我们就可以利用自由度为9的 t 分布,判断当前计算得到的 t 值是否足够异常。假设我们采用双侧检验,也就是只关心总体平均体重是否发生变化,而不预先指定它究竟是增加还是减少,那么 P-value 就是 t 分布两侧超过 和 的概率之和。
计算得到:
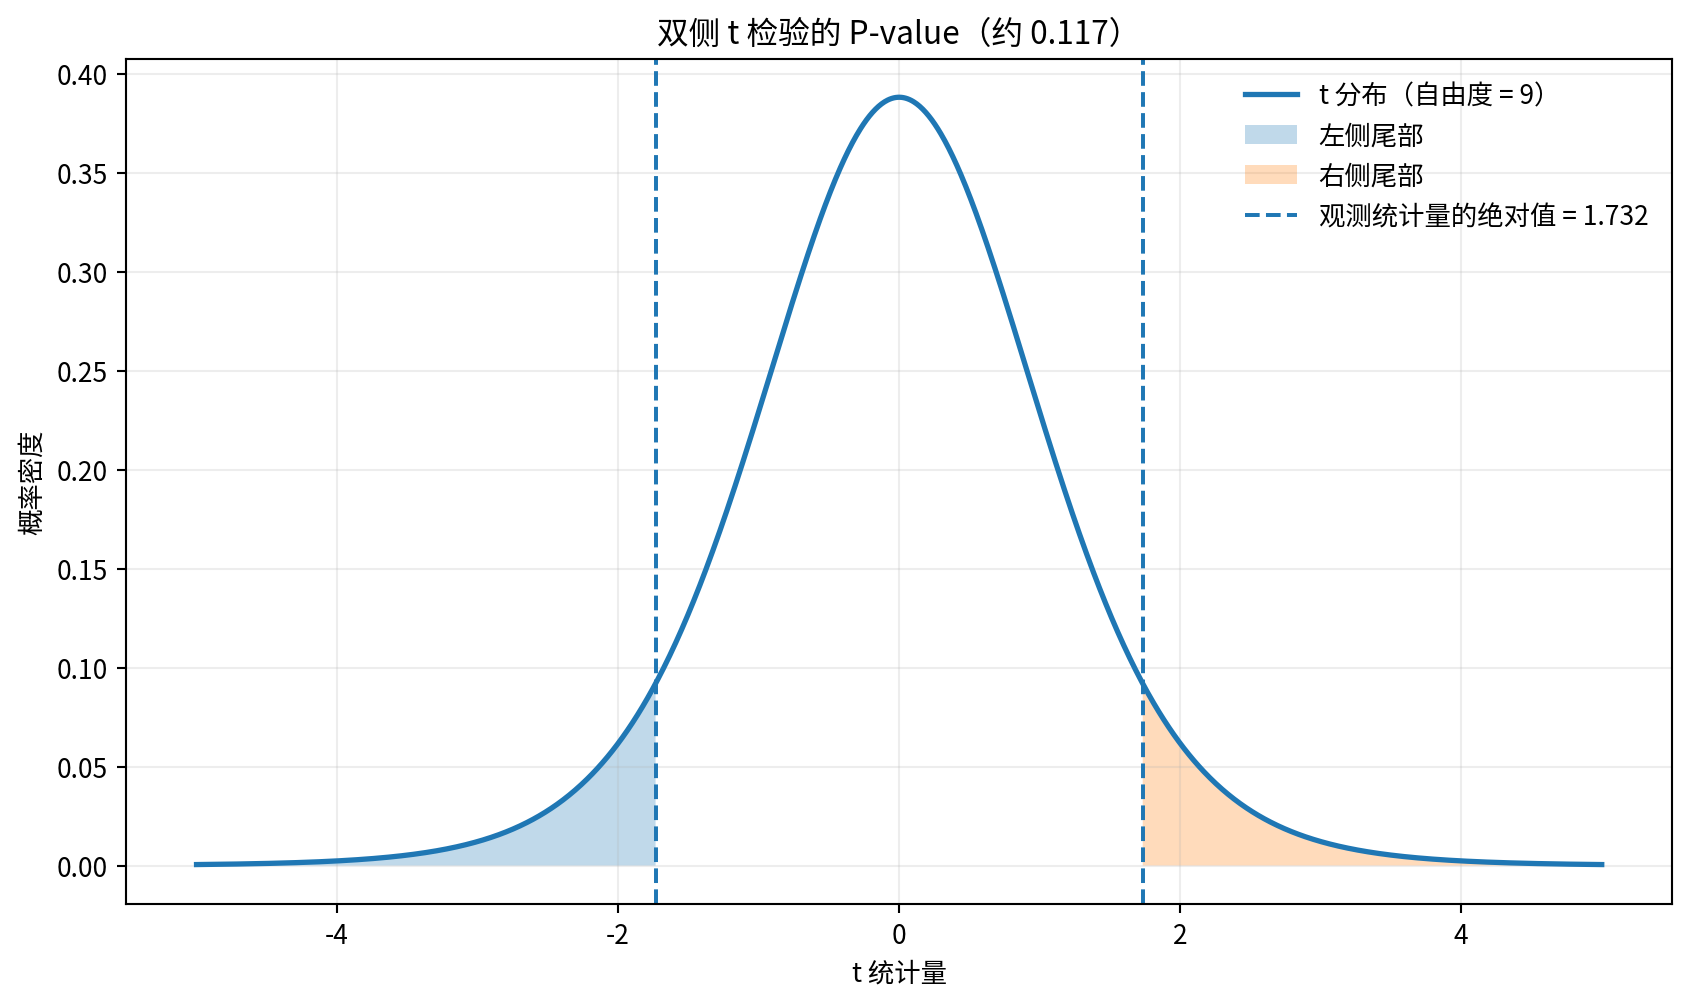
假设我们事先设定显著性水平为5%,即 。由于:
因此,我们没有足够的统计证据拒绝原假设。虽然样本平均体重比理论预期高了1克,但这种差异仍然可能来自正常的随机波动,我们暂时不能认定当地鸟类的平均体重已经发生了变化。
这里的 P-value 与上一章卡方检验中的含义完全相同,都是在原假设成立的前提下,观察到当前或更加极端检验统计量的概率。区别在于,两种检验使用了不同的概率分布,因此需要根据各自的分布计算相应的尾部面积。
t检验的类型
刚才介绍的是单样本 t 检验(One-sample t-test),它主要用于比较一个总体的平均值与某个事先给定的理论值。但现实中的研究问题往往更加复杂,我们可能需要比较两个不同群体的平均值,或者比较同一群体在不同条件下的平均值。根据研究设计的不同,t 检验主要可以分成三种类型。
第一种是单样本 t 检验。它的基本思想就是我们刚才使用的方法:从一个总体中抽取样本,计算样本平均值,然后判断它与某个假设的总体平均值之间是否存在显著差异。除了鸟类体重,我们还可以用它研究某个地区居民的平均收入是否达到特定水平,某种产品的平均使用寿命是否符合生产标准等。
第二种是独立样本 t 检验(Independent-samples t-test)。假设我们现在想比较两个不同地区的鸟类平均体重,分别从两个地区随机抽取样本,然后计算各自的样本平均值。此时,我们需要判断两个总体的平均体重是否存在显著差异。与单样本 t 检验不同,这里不再是将一个样本平均值与固定的理论值进行比较,而是直接比较两个独立样本的平均值。
如果我们能够合理假设两个总体的方差相等,可以使用合并方差 t 检验(Pooled t-test),其统计量为:
其中, 是合并标准差,用两个样本的信息共同估计总体的共同方差:
此时自由度为:
不过,两个总体方差相等并不是一个总能成立的假设。如果我们无法保证方差相等,更常用的办法是 Welch t 检验。它不要求两个总体具有相同的方差,统计量为:
Welch t 检验的自由度需要通过近似公式计算,不再简单等于 。实际数据分析中,如果没有充分理由假设两组方差相等,Welch t 检验通常是更稳妥的默认选择。
第三种是配对样本 t 检验(Paired-samples t-test)。它主要用于比较同一对象在两种不同条件下的测量结果。例如,我们想知道某种饲料是否能够增加鸟类的平均体重,可以先测量一批鸟在喂养前的体重,再经过一段时间测量它们喂养后的体重。由于前后两次测量来自同一批鸟,它们之间并不是相互独立的,因此不能简单地当作两个独立样本处理。
配对 t 检验的做法,是先计算每个对象前后两次测量的差值,再将这些差值看作一个新的样本,使用单样本 t 检验判断差值的总体平均值是否为零:
其中, 是所有配对差值的平均值, 是差值的样本标准差,自由度仍然为:
可以看到,配对 t 检验实际上就是对差值进行单样本 t 检验。它的优势在于,同一个对象前后变化可以相互比较,从而减少个体之间原本存在的差异对检验结果的干扰。
t分布与置信区间
除了假设检验,t 分布还有一个非常重要的用途:构造总体平均值的置信区间(Confidence Interval)。
我们刚才使用 t 检验判断总体平均体重是否等于29克,但如果我们不仅想知道29克这个假设是否合理,还想估计当地鸟类的总体平均体重究竟可能处于什么范围,就需要使用置信区间。
对于总体标准差未知的单样本均值问题,置信区间的计算公式为:
其中, 表示自由度为 的 t 分布中,右侧尾部面积为 时对应的临界值。
假设我们希望构造一个95%的置信区间,那么显著性水平就是:
由于自由度为9,查阅 t 分布表可以得到:
因此,我们的95%置信区间为:
最终得到:
也就是说,根据这10只鸟的样本数据,我们构造出的总体平均体重95%置信区间约为28.69克至31.31克。由于29克位于这个区间之内,因此与前面 t 检验没有发现显著差异的结论一致。
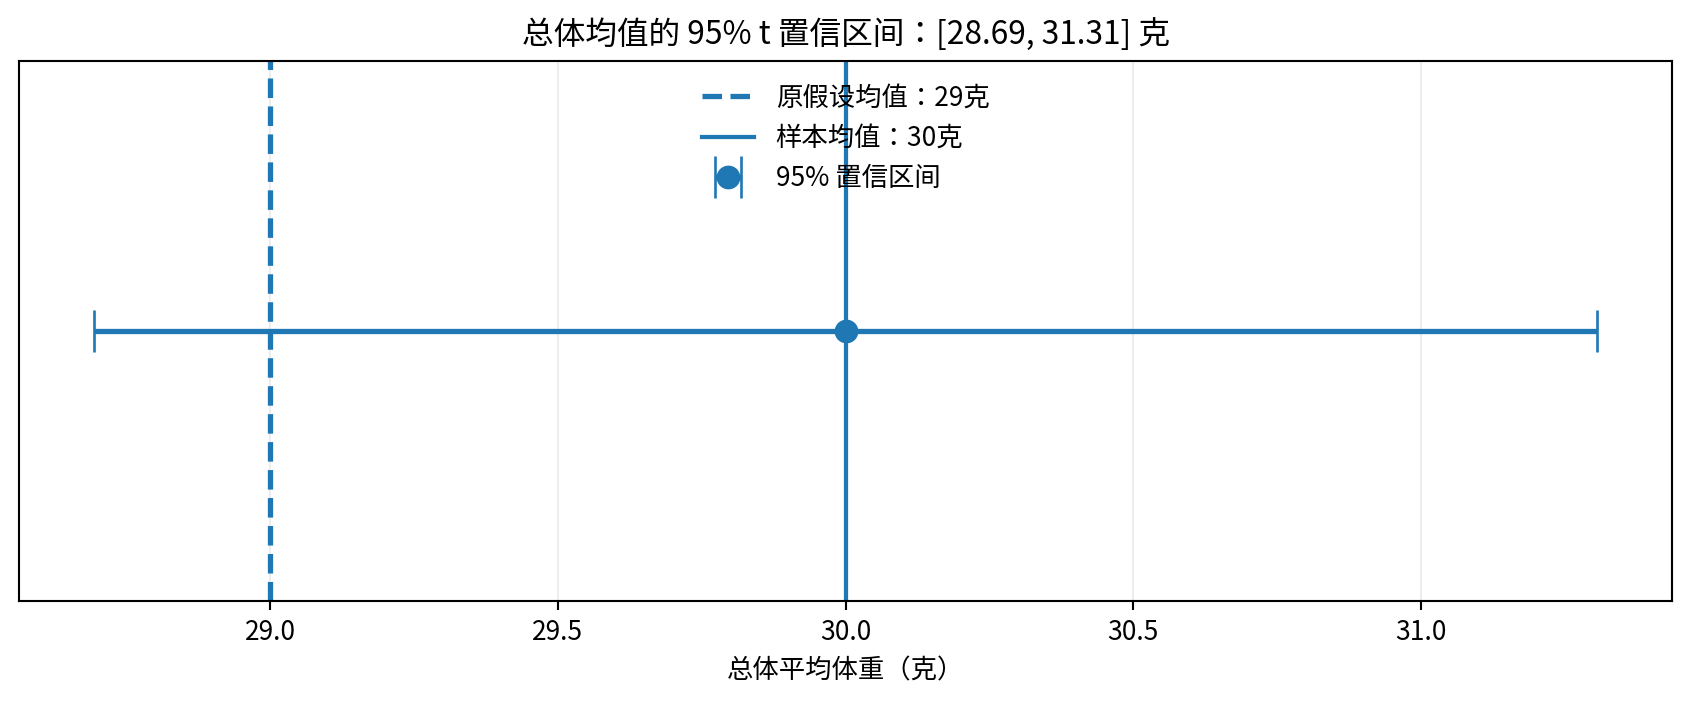
这里需要说明一个容易产生误解的地方。所谓95%置信区间,并不是说总体平均值有95%的概率落在我们已经计算出来的这个具体区间内。对于频率学派统计学而言,总体平均值是一个固定但未知的参数,随机变化的是我们每次抽样得到的区间。95%的含义是:如果我们在相同条件下不断重复抽样,并且每次都按照相同的方法构造置信区间,那么长期来看,大约95%的区间能够覆盖真实的总体平均值。
从这个角度来看,t 检验和置信区间其实是同一套统计理论的两种应用。前者帮助我们判断一个具体的假设是否能够被样本数据拒绝,后者则帮助我们估计总体参数可能处于什么范围。
t检验的适用条件与局限性
t 检验虽然是非常常见的统计方法,但它也有自己的适用条件。首先,样本应当具有合理的随机性,观测值之间需要满足相应的独立性要求。其次,对于小样本 t 检验,通常要求总体数据近似服从正态分布,尤其需要注意极端值和严重偏态的影响。样本量较大时,中心极限定理可以帮助样本平均值获得近似正态的抽样分布,因此对总体正态性的要求可以适当放宽,但这并不意味着任何异常数据都可以直接使用 t 检验。
对于独立样本 t 检验,还需要考虑两个样本是否相互独立,以及是否能够合理假设总体方差相等。如果方差不齐,通常应当使用 Welch t 检验。对于配对 t 检验,则应当重点检查配对差值的分布,而不是分别要求两次测量结果都服从正态分布。
此外,t 检验主要用于研究均值差异,并不能直接说明差异产生的原因,也不能单凭一个显著的 P-value 就认定某种因素具有因果作用。比如,我们发现某地区鸟类的平均体重显著高于另一个地区,并不意味着地区本身就是造成体重差异的原因。年龄、性别、食物来源和生活环境都可能产生影响。统计检验能够帮助我们判断差异是否具有统计显著性,却不能代替对现实机制的进一步研究。